

En l’espace d’une semaine, les géants de l’IA ont sifflé la fin de la récréation : fin annoncée ou bridage de l’utilisation des forfaits individuels pour alimenter les “petits” agents OpenClaw/Hermes & Co, et autres systèmes automatisés. L’usage de ces abonnements, qui n’étaient déjà plus réellement des forfaits totalement illimités, était quasiment la règle pour tous les power users. L’avantage ? Pouvoir utiliser un forfait sans soucier de la consommation réelle en tokens de son agent, contrairement à une utilisation par API qui depuis le début est facturée à la consommation réelle de tokens.
Les entreprises le savent depuis un moment, la facturation à la consommation de tokens fait exploser les coûts : la conséquence directe est qu’il faut tout optimisé pour consommer le moins possible. Ce que peu d’utilisateurs en usage individuel, même les plus aguerris, ont pris en compte depuis ces derniers mois. Mais la situation est devenue de moins en moins tenable, et elle est certainement écrite depuis un moment, en particulier pour Anthropic, dans une moindre mesure pour OpenAI, et même un peu pour Google ou Microsoft.
La raison ? Là où un humain avec son forfait à 20 dollars fait 20 , 30 ou même 100 interactions par jour dans sa fenêtre de chat, ou dans son CLI, un agent peut en faire des centaines ou des milliers en quelques dizaines de minutes ou en quelques heures. Un par un les géants ont donc décidé de casser ce système. Et de faire grimper la facture en fonction de l’usage.
Sommaire
La semaine où le forfait illimité a cessé de faire semblant d’être illimité
Tokens moins chers, IA plus chère
La f(r)acture humain / agent
Combien ça coûte ? Ce que les études commencent à dire sur le coût réel
Le repricing silencieux : l’exemple du tokenizer
La folie du tokenmaxxing
L’avantage n’est déjà plus le prix
Temps de lecture : 30 mins
Cet article est payant. Vous pouvez en lire le début.
Vous pouvez modifier vos préférences de réception ou vous désabonner sur la page de votre compte
La newsletter du samedi matin reste gratuite.
La semaine où le forfait illimité a cessé de faire semblant d’être illimité
Le 13 mai 2026, le compte officiel ClaudeDevs annonçait sur X qu’à partir du 15 juin, les abonnements Claude payants seraient découpés en deux pools distincts.
D’un côté, l’usage par un humain derrière le clavier, à travers une interface web, comme le chat dans le navigateur, ou en CLI avec Claude Code en terminal, ou encore avec Claude Cowork, qui vont continuer à puiser dans les limites habituelles des forfaits que nous connaissons depuis bientôt 3 ans : pas totalement illimités mais assez souples.
De l’autre, l’usage par agent : Claude piloté par un logiciel, sans humain au clavier. C’est le cas des harnais tiers comme OpenClaw ou Hermex, de l’Agent SDK (le kit d’Anthropic pour construire des agents), ou encore de la commande claude -p, qui fait tourner Claude en mode « headless », par exemple à l’intérieur d’un script ou d’une chaîne d’intégration. Tout cet usage-là bascule sur une enveloppe mensuelle séparée du forfait individuel, dont la consommation est décompté aux tarifs API standard : 20 dollars de crédits pour l’enveloppe Pro, 100 pour la Max 5x, 200 pour la Max 20x, non reportables. Une fois les crédits épuisés, deux options : soit l’utilisateur active la facturation “extra usage” à la consommation, et la note peut alors grimper très vite, soit son automatisation s’arrête jusqu’au cycle suivant. Au tarif Sonnet 4.6, 20 dollars de crédit API représentent environ 6,6 millions de tokens en entrée, ou 1,3 million en sortie. Il est courant de voir une session agentique avec un grand contexte brûler 100 000 à 200 000 tokens. Autrement dit, le crédit Pro peut être épuisé en quelques dizaines de sessions. Oh la belle création de rente !
Le même jour, à moins d’une heure d’intervalle plus tard sur X, OpenAI répondait par la voix de Sam Altman : “2 mois de Codex Enterprise gratuits pour toute entreprise qui migre dans les 30 jours.” Deux mois de gagnés.
Ce n’est pas fini, car dans la foulée là aussi à quelques dizaine de minutes d’intervalle, toujours sur X, Anthropic ajustait sa communication et son offre offre commerciale et répondait à OpenAI en relevant de 50 % les limites hebdomadaires de Claude Code jusqu’au 13 juillet, soit une fenêtre temporelle qui recouvre presque exactement la promotion concurrente.
Cette séquence de communication commerciale entre les deux Labs IA qui dictent leur agenda depuis plus de 3 ans maintenant, a été vue et lue par beaucoup comme une guerre des prix. Comme d’autres, je pense que c’est plus ça.
Ce qui s’est joué ce jour là et dans les jours qui ont suivi jusqu’à la Google I/O du 19 mai, c’est l’entrée explicite de tout le secteur dans l’économie du token.
Quand je dis “tout le secteur”, je parle de tous les acteurs de ce marché, en amont et en aval, y compris les utilisateurs individuels qui n’avaient pas encore conscience qu’ils allaient être comme les entreprises soumis à un régime de facturation et de gestion des coûts où l’unité comptable de base n’est plus l’utilisateur, ni la requête, ni la session, mais le “calcul” / le “compute” effectivement consommé. Donc le token.
Le 19 mai, soit 6 jours plus tard, Sundar Pichai a enfoncé le clou lors de la keynote Google I/O 2026. Le CEO d’Alphabet a livré le chiffre qui a rendu le sujet impossible à ramener seulement à un duel Anthropic vs OpenAI : les plateformes Google traitent désormais 3,2 quadrillions de tokens par mois, soit une multiplication par 7 en un an, après une multiplication par 50 entre mai 2024 et mai 2025. Et il a confirmé publiquement un constat que The Information documentait depuis avril sur les cas d’Uber et de ServiceNow : “nous avons entendu dire que de nombreuses entreprises avaient déjà épuisé leur budget annuel en jetons, alors que nous ne sommes qu’en mai.”
Le CEO du principal hyperscaler vient donc d’acter, lors d’un des événements les plus suivis de l’année dans le monde IA, ce que les fournisseurs concurrents découpent en politique de pricing sans le nommer : “token is gold”. Et la ruée a commencé.
Le token est réellement devenu cette semaine l’unité de base, la définition même du coût de toutes les actions que nous déléguons et allons peut-être déléguer de plus en plus aux machines. Et en particulier, ce que nous allons déléguer à ce que nous appelons actuellement “les agents”. Ces agents, ou plus précisément ceux qui les “fabriquent”, les “contrôlent” et les “commercialisent”, vont facturer leurs clients en fonction des tokens consommés.
Tokens moins chers, IA plus chère
Pour comprendre ce qu’il se passe en ce moment, il faut regarder 2 choses.
D’un côté, le coût unitaire de production du token continue de chuter rapidement. Dans sa communication financière de Q4 2025 de Google, publiée le 4 février 2026, Pichai a précisé que les coûts unitaires de service de Gemini avaient été abaissés de 78 % sur l’année, soit une amélioration de 4,5 fois du rapport tokens/GPU/heure. L’AI Index Report 2026 de Stanford HAI, publié en avril, fournit un regard plus matériel sur ce qui rend le coût du token plus abordable : la capacité mondiale de compute IA a augmenté de plus de 3 fois par an depuis 2022 pour atteindre 17,1 millions d’équivalents H100 fin 2025, en additionnant les GPU Nvidia, les TPU Google et les puces Amazon.
A noter que dans ce même rapport, les auteurs identifient l’inférence, et non plus l’entraînement, comme le principal moteur de l’expansion des besoins matériel et de consommation de tokens, et rappelle qu’à benchmark de performance constant, les prix d’inférence ont baissé de 9 à 900 fois par an selon les tâches.
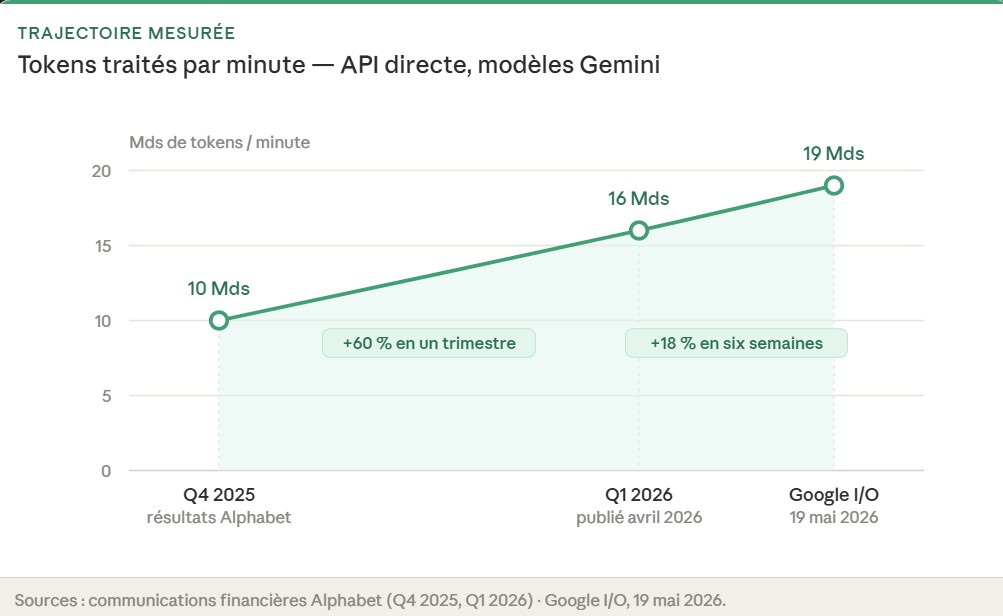
De l’autre côté, le volume globale de tokens consommés explose à un rythme qui rend la baisse du coût unitaire entièrement absorbée et non visible par les utilisateurs et entreprises. Toujours dans la même communication Google Q4 2025, le CEO d’Alphabet indique que les modèles Gemini traitent désormais plus de 10 milliards de tokens par minute via l’API directe. Et la communication suivante sur Q1 2026, qui a été rendue public en avril, montre un nouveau bond à 16 milliards, soit +60 % en un trimestre. À l’I/O 2026 du 19 mai, Pichai annonce 19 milliards de tokens par minute via API directe , soit+18 % en six semaines - c’est foufou non ? - et confirme que 375 clients Google Cloud avaient désormais dépassé le seuil du trillion de tokens consommés sur les douze derniers mois, contre 330 en avril, soit +45 nouveaux clients en six semaines, mais vous aviez fait ce dernier calcul tout seul… pas besoin d’inférer.
Côté Microsoft, la communication Q2 FY2026 du 28 janvier 2026 indiquait déjà que plus de 250 clients étaient en passe de consommer plus d’un trillion de tokens sur Azure Foundry. Satya Nadella, le patron de Microsoft, formalisait dans le même temps une métrique-clé de la nouvelle économie du token : tokens per watt per dollar soit la quantité utile produite par unité d’énergie et de capital.
Les ordres de grandeur des 2 principaux hyperscalers se recoupent, et tracent la même courbe : la consommation totale de tokens double tous les deux à quatre mois. Le chapitre Economie de l’AI Index 2026 de Stanford résume la situation actuelle en une formule : “le chiffre d’affaires des entreprises d’IA progresse à des rythmes historiquement élevés, mais les coûts de calcul et l’investissement en infrastructure atteignent eux aussi des niveaux records”. Le rapport pointe Google comme illustration : pour absorber cette explosion d’usage, l’entreprise a investi plus de 150 milliards de dollars dans ses infrastructures en 2025. Et l’effort s’accélère, Pichai a annoncé le 19 mai un budget d’environ 190 milliards pour 2026, contre 31 milliards quatre ans plus tôt.
Avec tout ces chiffres, les analystes financiers s’attendent un retournement par rapport à ce que le marché vit depuis 3 ou 4 ans. Une note de Goldman Sachs du 5 mai 2026 (”Decoding the Agentic Economy”), reprise par Fortune le 13 mai, situe ce retournement dans les 3 à 12 prochains mois.
Jusqu’ici, plus un fournisseur vendait de tokens, plus il creusait ses pertes, car globalement il facturait en dessous de son coût. Goldman Sachs annonce le moment où ce rapport s’inverse : le coût de calcul baisse désormais assez vite pour que la consommation, enfin, devienne rentable.
Et vous savez quoi ? Cette semaine, Anthropic a annoncé son premier trimestre bénéficiaire… Bien plus rapidement qu’anticipé par les analystes de Goldman Sachs.
La note de Goldman Sachs, accessible aux clients institutionnels, anticipe une multiplication par 24 du volume mondial de tokens d’ici 2030, ce qui est un ordre de grandeur compatible avec les trajectoires observées chez Google et Microsoft sur les douze derniers mois.
Cette mise en cohérence économique, c’est à dire de faire payer la consommation au token réel, a surtout un calendrier bien plus explicite et rapproché de nous. OpenAI et Anthropic ont bouclé au premier trimestre 2026 des levées records, et sont attendus pour leur entrée en bourse à moyen terme. Or aucun marché boursier ne tolère durablement l’écart entre un revenu d’abonnement forfaitaire et un coût de calcul variable : tant que les deux sont découplés, rien n’est vraiment mesurable, surtout la marge, et la facturation à l’usage est la voie la plus rapide pour la rendre lisible. La pression financière ne crée pas réellement le mouvement de repricing actuel que nous subissons, cela devait arriver, mais cette pression en fixe une échéance que Sam Altman et Darion Amodei doivent avoir en tête. Et cette échéance se rapproche.
La belle histoire de la logique tarifaire des 18 derniers mois reposait sur une supposition fantasmée, un conte de fées pour des enfants gâtés : que les tokens deviendraient quasi gratuits et que les abonnements illimités tiendraient. Cela ne tient plus, ou plutôt, cela n’a jamais vraiment tenu. Non parce que la 1ère proposition est fausse, les tokens deviennent effectivement quasi gratuits à l’unité, mais parce que la 2ème ignore que la consommation se redessine et explose : l’augmentation de l’utilisation de ce qu’on nomme globalement l’IA, donc de l’inférence, est spectaculaire.
Chaque token coûte de moins en moins cher, mais on en consomme tellement plus que la facture totale grimpe quand même. Et la raison de cette explosion tient en une explication : tant qu’un humain est aux commandes, sa consommation a une limite naturelle, celle de ce qu’il peut lire et écrire dans une journée. Un agent n’a pas cette limite : il consomme tant qu’on le laisse tourner, autrement dit, tant qu’il reste du budget.
Le scénario que je viens de décrire pour la relative non limitation des abonnements suivie d’une mise en place de quotas ou d’un paiement plus agressif n’est pas nouveau. La tech l’a déjà joué : on offre un service à perte, le temps d’attirer les utilisateurs et de les rendre dépendants. Puis, une fois qu’ils ne peuvent plus partir, on remonte les prix. Les VTC vendus moins cher que le taxi, les abonnements de streaming à prix cassés et sans pub, les services cloud quasi gratuits pour les start-ups, tous ont connu ce passage. D’abord conquérir le marché à perte, ensuite le faire payer. Beaucoup. L’IA entre dans le second temps, avec un découpage particulier : les humains d’un coté, les machines de l’autre.
La f(r)acture humain / agent
Le découpage décidé et assumé ouvertement le 13 mai par Anthropic n’est pas seulement un ajustement tarifaire. En réalité, Anthropic avait déjà commencé à imposer ce découpage dès le début de l’année, quand l’usage d’OpenClaw avait explosé, forçant le géant à prendre des mesures de restrictions d’utilisation. Cette distinction, entre usage humain et usage agent, est une décision de structure et l’argument technique, sur laquelle elle repose, est logique.
Boris Cherny, responsable de Claude Code, l’avait formulé sur X le 3 avril 2026, à l’occasion d’une première restriction : “our subscriptions weren’t built for the usage patterns of these third-party tools”. Un humain au clavier envoie quelques dizaines, parfois quelques centaines de prompts par jour. Un agent autonome qui exécute, teste, navigue, rappelle le modèle en boucle, lui opère à un autre ordre de grandeur. Avec un forfait unique humain et agent, l’utilisateur intensif d’agents coûte bien plus cher qu’il ne paie. Et la différence est comblée par quelqu’un : soit par les utilisateurs occasionnels, qui paient le même prix pour une fraction de la consommation, soit par le fournisseur, qui rogne sa marge.
La décision d’Anthropic n’est pas isolée et n’est même pas la première du genre. Le 27 avril dernier, GitHub a annoncé que l’ensemble des plans Copilot va basculer au 1ᵉʳ juin sur un modèle “d’AI Credits” indexés sur la consommation de tokens. GitHub a justifié le changement assez directement et simplement : Copilot n’est plus le même produit qu’un an plus tôt, il fait désormais tourner des tâches automatisées bien plus lourdes en puissance de calcul. L’ancien décompte de requêtes est remplacé par des crédits libellés en euros, où un crédit IA vaut un centime. Mais surtout le basculement est imposé à tous : les abonnés mensuels y passent automatiquement, et les contrats annuels ne sont plus reconduits tels qu’ils étaient. Tout le monde bascule au moment du renouvellement.
Mais attention, n’allons pas trop vite. L’économie du token décrite ici depuis le début ne signifie pas la fin universelle et globale du forfait grand public et de son abonnement dédié. Pas encore en tout cas. En revanche, il faut bien constater que le principal consommateur de ce type d’abonnement, ce grand public, est bien touché directement… Mais là aussi cela ne date pas d’hier. Les forfait individuels, ChatGPT Plus, Claude Pro, les abonnements Google AI Pro, tous autour de vingt dollars par mois, n’ont en réalité jamais été illimités : par exemple des restrictions en nombre de messages échangés ou de documents uploadés sont en place depuis le début. Mais ces limites glissent progressivement depuis un moment déjà vers une autre logique : une logique de temps de calcul consommé, c’est à dire de tokens consommés. L’abonnement payant à Claude fonctionne ainsi avec une fenêtre glissante de cinq heures et un plafond hebdomadaire d’utilisation depuis l’été 2025. Mais surtout, l’usage n’y est pas compté en messages, mais pondéré par la longueur de la conversation, le modèle choisi et les fonctionnalités mobilisées. Et la référence de tout ça, c’est le token. Beaucoup ont appris de manière empirique qu’un long document pdf uploadé dans la conversation “brûle” le quota plus vite qu’une question brève. Et qu’il faut ensuite attendre 5 heures ou sortir sa CB.
Ce 19 mai, Google a poussé cette logique un cran plus loin et surtout l’a nommée explicitement : son application Gemini abandonne les limites en nombre de requêtes pour un modèle dit “compute-used”, c’est à dire un plafond calculé sur la complexité du prompt et la longueur de l’échange, assorti d’une bascule automatique vers un modèle plus léger lorsque le quota est atteint. En quelques mots : un système de quota basé sur le nombre de tokens consommés. Mais la nouveauté la plus importante est la mise en place d’un système d’achat de crédits supplémentaires, comme chez Claude, permettant à l’utilisateur de poursuivre son un action sans attendre la remise à zéro de son compteur, lorsque qu’il se retrouve bloqué.
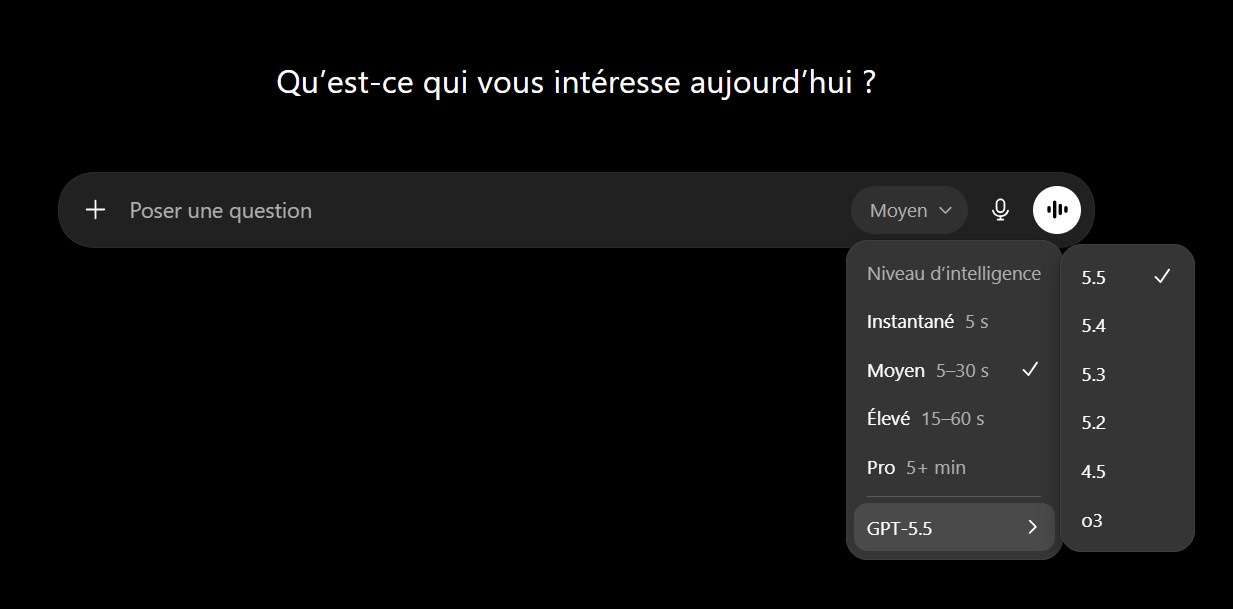
ChatGPT, de son côté, conserve à ce jour des plafonds exprimés en messages et n’offre pas ce complément payant sur son offre individuelle : sur ce point précis, il est en retard sur ses deux concurrents. Jusqu’à quand ? Et peut-être que la nouvelle interface de sélection de modèles et de choix de “niveau d’intelligence” apparue ces dernières heures dans ChatGPT est plus pernicieuse qu’elle n’en a l’air… Une autre façon d’adresser la problématique, moins directe.
Ce qui survit dans le grand public n’est donc pas le forfait illimité. C’est l’absence de facture ouvertement basée sur la consommation effective de tokens. L’utilisateur individuel ne reçoit pas de relevé de calcul : il se heurte à un mur de quota, et au pire achète un petit ou un gros complément forfaitaire.
